NASA e IBM lanzan un modelo de IA abierto para explorar la Luna
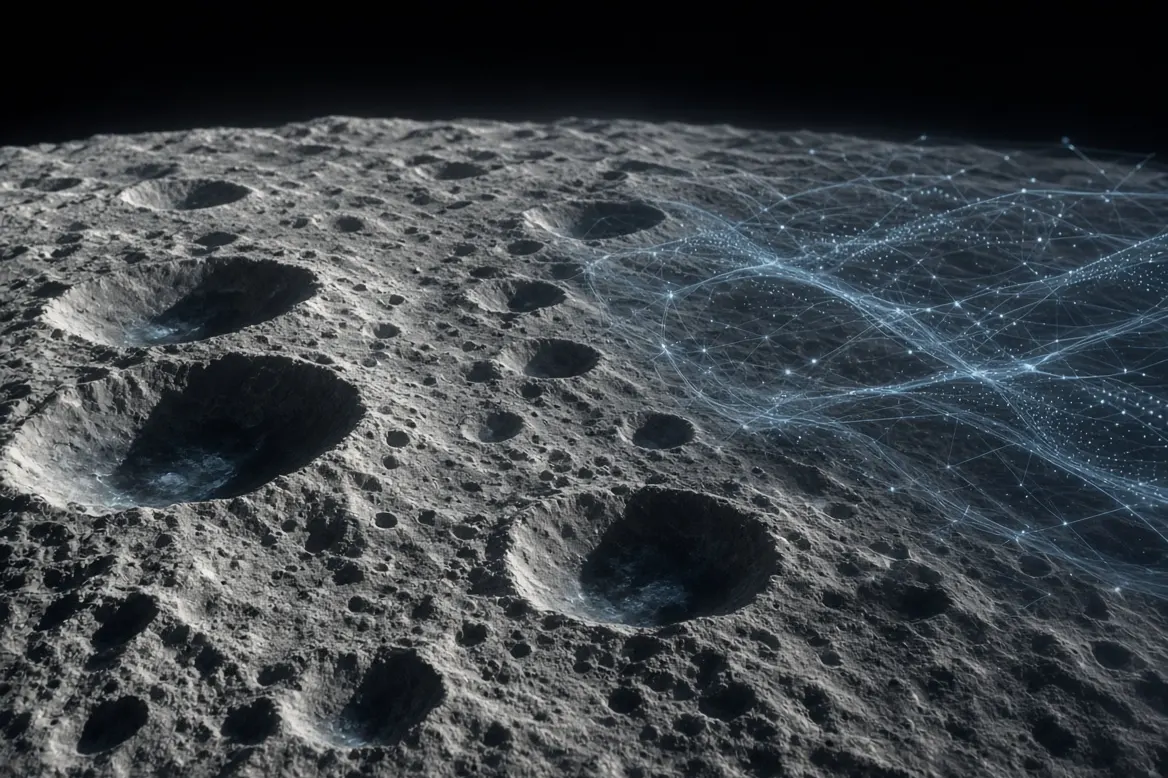
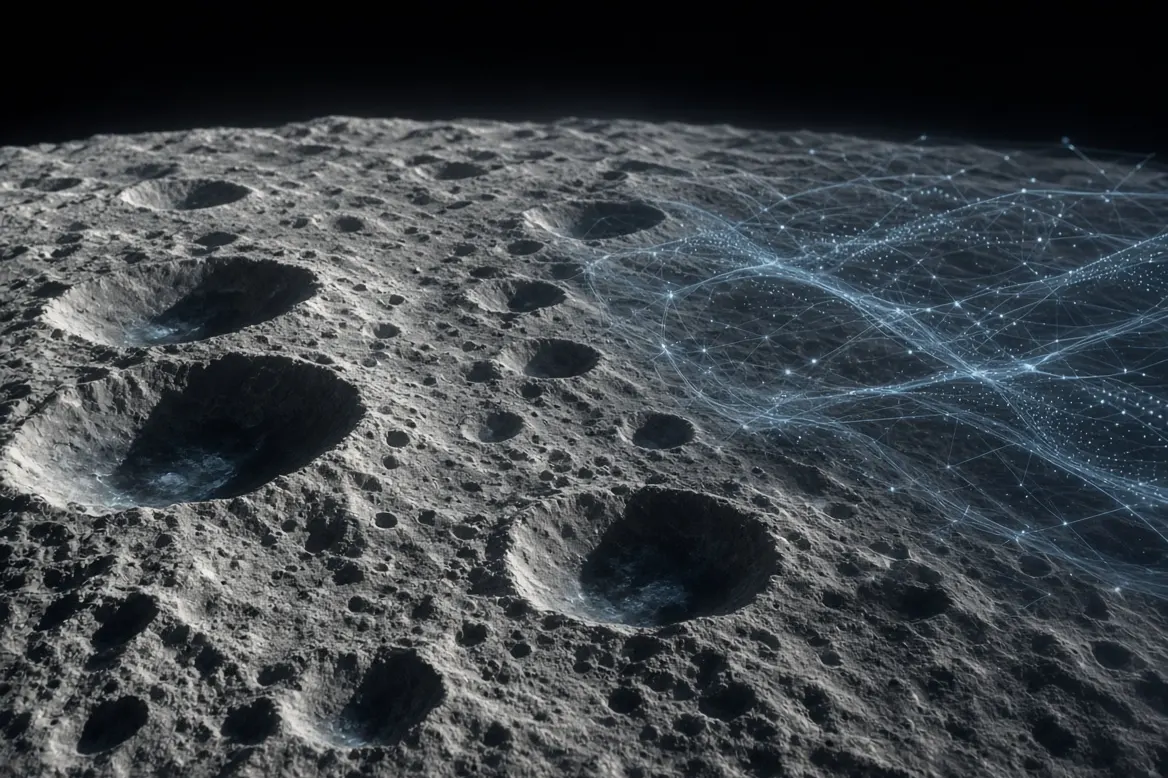
NASA e IBM presentaron el NASA-IBM Lunar Foundation Model, un sistema de inteligencia artificial de código abierto orientado a facilitar el estudio de la Luna en el marco de las misiones Artemis. El modelo ya está disponible para descarga en Hugging Face y busca convertirse en una herramienta útil para investigadores que trabajan con imágenes e instrumentación lunar.
Según explicó el doctor Juan Bernabé-Moreno, director de IBM Research Europe para el Reino Unido e Irlanda, el modelo se destacó especialmente a la hora de señalar zonas de la superficie lunar donde podría haber hielo. En una prueba comparativa contra un mapa elaborado con un flujo de trabajo científico publicado, que combina datos de terreno, térmicos y ambientales, el sistema redujo los errores un 23 por ciento frente a SwinV2-B, un modelo de visión de Microsoft habitualmente usado como referencia en tareas de análisis de imágenes de alta resolución.
También midieron su capacidad para identificar y clasificar cráteres. Allí el modelo de NASA e IBM superó a SwinV2-B por un 19 por ciento y lo hizo utilizando la mitad de los datos de entrenamiento. Una verificación reciente llegó cuando un cohete Falcon 9 de SpaceX impactó en la Luna el 5 de agosto. Al recibir la imagen del impacto, el sistema reconoció correctamente el sitio como un cráter nuevo, a pesar de que se superponía casi por completo con uno ya existente. “Funcionó de manera fantástica”, afirmó Bernabé-Moreno, y destacó que acertó en el primer intento.
El entrenamiento del modelo no fue sencillo. En la observación de la Tierra las imágenes suelen tener sombras suaves porque la atmósfera dispersa la luz. En la Luna, en cambio, las sombras son nítidas y completamente negras, de modo que los píxeles en sombra no aportan información. Un mismo cráter puede verse de formas muy distintas según el momento del día en que se toma la foto.
Cómo resolvieron el problema de las sombras y los cráteres parecidos
Los métodos tradicionales de entrenamiento de modelos de visión tampoco resultaron útiles. Habitualmente se ocultan partes de una imagen y se le pide al sistema que reconstruya lo faltante. En la Luna esa estrategia falló porque muchos cráteres se parecen demasiado entre sí cuando se los fotografía desde la órbita. Bernabé-Moreno contó que los primeros intentos fueron “un desastre total”.
La solución que encontraron consistió en dividir la Luna en secciones como si fuera una naranja y separar por completo las zonas usadas para entrenar de las usadas para probar. De esa manera el modelo obtuvo mayor consistencia y pudo aprender patrones sin contaminarse con datos de las mismas regiones.
Además del modelo, NASA e IBM liberaron un dataset open source de primera vez. Incluye decenas de miles de imágenes y datos de instrumentos de las misiones Lunar Reconnaissance Orbiter y Gravity Recovery and Interior Laboratory de la NASA, junto con información de la misión SELENE de Japón. El material está co-registrado: cada píxel de imagen corresponde a otras modalidades de datos que el modelo puede aprovechar.
Bernabé-Moreno subrayó que esa organización de la información representa un aporte científico de peso. “La comunidad ahora tiene un dataset co-registrado con más de dos millones de puntos de datos”, señaló. Y agregó que, si bien los modelos de inteligencia artificial suelen ser superados por versiones posteriores, los datos son lo que realmente sostiene el desarrollo de esta industria.